两台Spark“并联”真比一台好吗?
结论
联机优势,跑大尺寸模型,对单个请求延迟有高要求。否则单机部署更灵活。
| 测试项 | 单机 | 双机 | 实际提升 |
|---|---|---|---|
| 并发 3 路 | 10.63 tok/s | 15.07 tok/s | +42% |
| 长文本 | 3.76 tok/s | 6.10 tok/s | +62% |
| 短文本 | 3.52 tok/s | 5.15 tok/s | +46% |
背景
本次采购两台 NVIDIA DGX Spark,搭载 GB10 Blackwell GPU,128GB 统一内存。本次测试旨在验证在这套硬件上运行大型语言模型的推理能力,并对比单机与双机分布式部署的性能差异。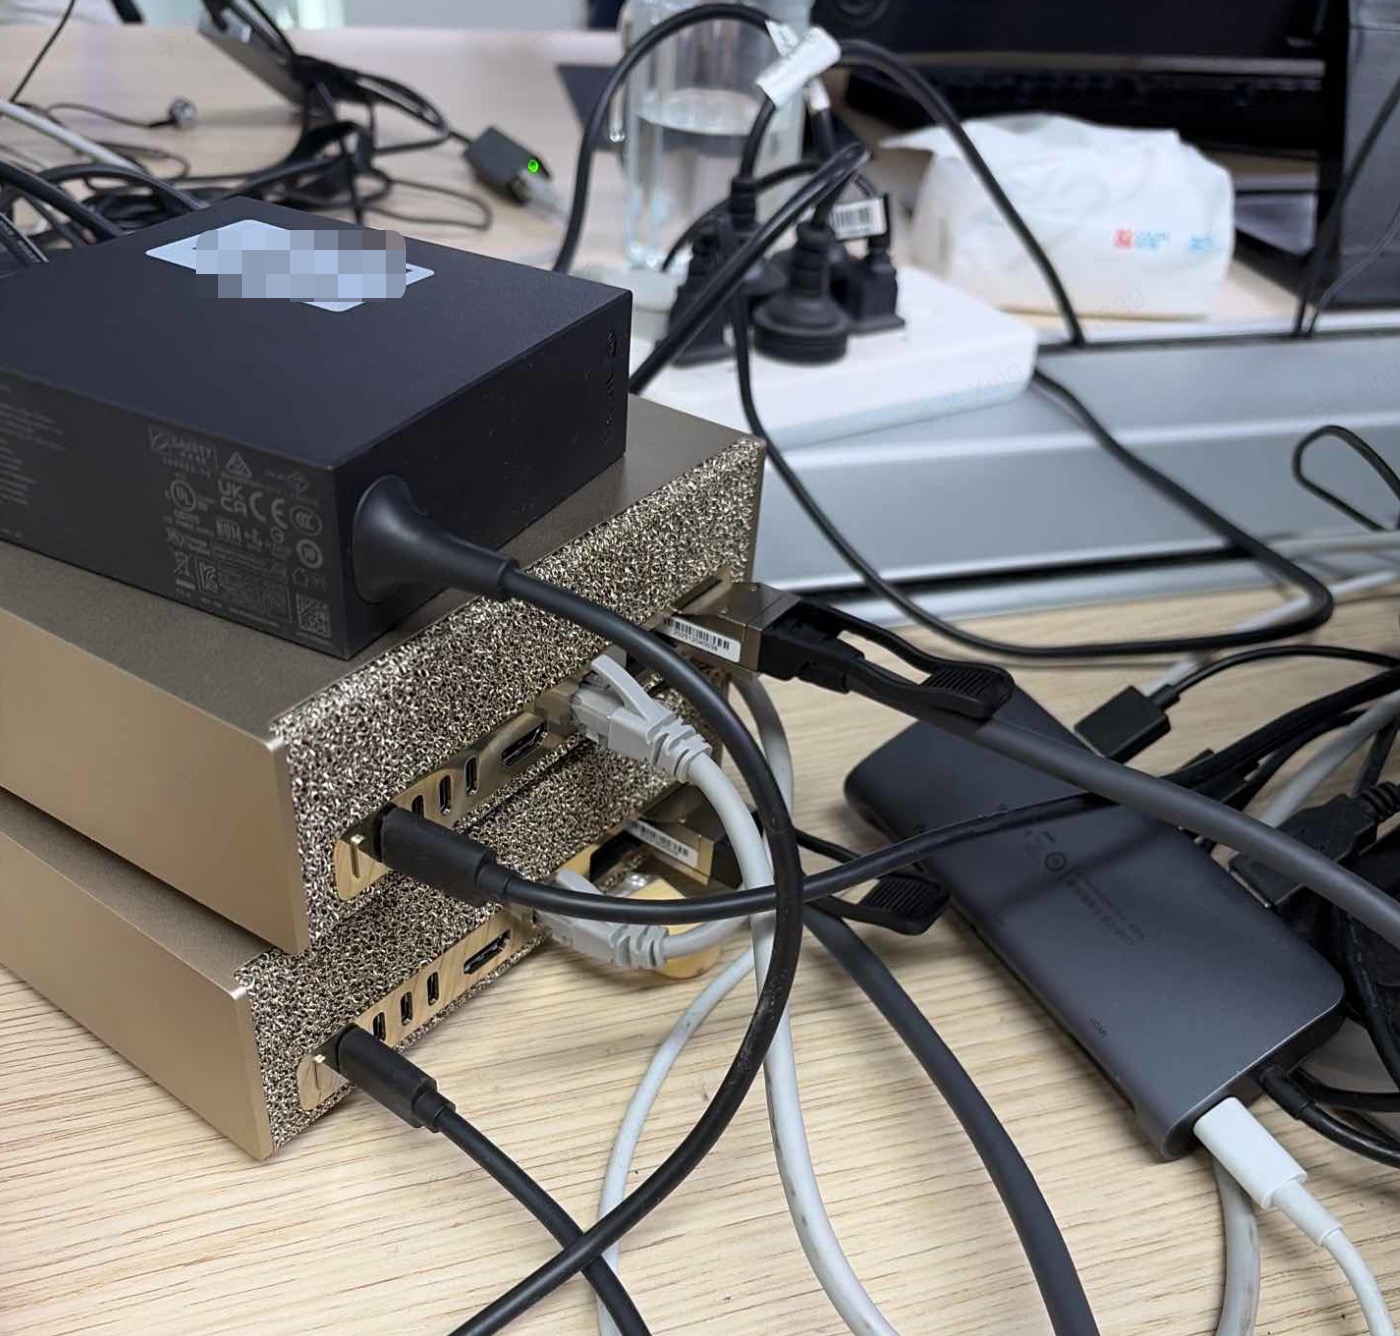
技术选型
硬件,https://docs.nvidia.com/dgx/dgx-spark/spark-clustering.html 使用QSFP112 DAC 400G铜缆连接,软件选用业界标准ray,由 UC Berkeley(加州大学伯克利分校) 的 RISELab 实验室在 2017 年发布,最初是为了解决强化学习的分布式训练问题。
vLLM(前端 API)
      ↓ 下达指令
    Ray 集群
   /         \
spark03       spark02
(GPU 分片0)  (GPU 分片1)
模型选择
选用谷歌最近推出的模型google/gemma-4-31B-it,模型尺寸62GB,KV Cache 40GB,基本占满一台spark的所有性能。测试单机与集群推理性能;Qwen3.5-122B-A10B 阿里的混合专家模型,通过 --tensor-parallel-size 2 将模型切成两半,每台机器各持 ~65GB 权重,通过 200GbE 高速线缆做实时 NCCL 通信,共同完成推理。
| 模型 | 参数规模 | 量化 | 定位 |
|---|---|---|---|
| Gemma 4 31B-IT | 31B | BF16(原始精度) | Google 多模态对话模型,单机测试对象 |
| Qwen3.5-122B-A10B | 122B(MoE,激活 10B) | FP8 | 阿里超大 MoE 模型,双机测试对象 |
结论细节
联机优势,跑大尺寸模型,对单个请求延迟有高要求。否则单机部署更灵活。
| 测试项 | 单机 | 双机 | 实际提升 |
|---|---|---|---|
| 并发 3 路 | 10.63 tok/s | 15.07 tok/s | +42% |
| 长文本 | 3.76 tok/s | 6.10 tok/s | +62% |
| 短文本 | 3.52 tok/s | 5.15 tok/s | +46% |
单机gemma-4-31b-it
| 测试项 | Prompt Tokens | 生成 Tokens | 耗时(s) | 速度(tok/s) |
|---|---|---|---|---|
| 短文本(128) | 20 | 128 | 36.339 | 3.52 |
| 长文本(512) | 48 | 512 | 136.212 | 3.76 |
| 推理能力(512) | 81 | 512 | 136.251 | 3.76 |
| 并发3路(128×3) | — | 384 | 36.14 | 10.63 |
联机gemma-4-31b-it
| 测试项 | Prompt Tokens | 生成 Tokens | 耗时(s) | 速度(tok/s) |
|---|---|---|---|---|
| 短文本(128) | 20 | 128 | 24.863 | 5.15 |
| 长文本(512) | 48 | 512 | 83.894 | 6.10 |
| 推理能力(512) | 81 | 512 | 82.829 | 6.18 |
| 并发3路(128×3) | — | 384 | 25.48 | 15.07 |
联机Qwen3.5-122B-A10B
| 测试项 | Prompt Tokens | 生成 Tokens | 耗时(s) | 速度(tok/s) |
|---|---|---|---|---|
| 短文本(128) | 17 | 128 | 14.985 | 8.54 |
| 长文本(512) | 44 | 512 | 39.375 | 13.00 |
| 推理能力(512) | 66 | 512 | 27.464 | 18.64 |
| 并发3路(128×3) | — | 384 | 8.84 | 43.44 |
测试过程
#!/bin/bash
# ============================================================
# LLM 性能基准测试脚本
# 适用于所有 OpenAI 兼容 API(vLLM / llama.cpp / Ollama 等)
# 用法: ./benchmark_llm.sh <API_URL> <MODEL_NAME> [LABEL]
# 示例: ./benchmark_llm.sh http://10.14.3.126:8000 qwen35-122b-fp8 "双机TP2"
# ============================================================

set -euo pipefail

API_URL="${1:?用法: $0 <API_URL> <MODEL_NAME> [LABEL]}"
MODEL="${2:?请指定模型名称}"
LABEL="${3:-$MODEL}"
TIMESTAMP=$(date +%Y%m%d_%H%M%S)
RESULT_FILE="benchmark_results_${TIMESTAMP}.md"

# 颜色
GREEN='\033[0;32m'
YELLOW='\033[1;33m'
CYAN='\033[0;36m'
NC='\033[0m'

echo -e "${CYAN}========================================${NC}"
echo -e "${CYAN} LLM 性能基准测试${NC}"
echo -e "${CYAN} 模型: ${MODEL}${NC}"
echo -e "${CYAN} 端点: ${API_URL}${NC}"
echo -e "${CYAN} 标签: ${LABEL}${NC}"
echo -e "${CYAN}========================================${NC}"

# ---- 辅助函数 ----
call_api() {
  local prompt="$1"
  local max_tokens="${2:-256}"
  local temp="${3:-0.7}"

  curl -s -w "\n%{time_total}" "${API_URL}/v1/chat/completions" \
    -H "Content-Type: application/json" \
    -d "{
      \"model\": \"${MODEL}\",
      \"messages\": [{\"role\": \"user\", \"content\": \"${prompt}\"}],
      \"max_tokens\": ${max_tokens},
      \"temperature\": ${temp},
      \"stream\": false
    }" 2>/dev/null
}

call_api_stream() {
  local prompt="$1"
  local max_tokens="${2:-256}"

  local start_time=$(python3 -c "import time; print(time.time())")
  local first_token_time=""
  local token_count=0

  curl -s -N "${API_URL}/v1/chat/completions" \
    -H "Content-Type: application/json" \
    -d "{
      \"model\": \"${MODEL}\",
      \"messages\": [{\"role\": \"user\", \"content\": \"${prompt}\"}],
      \"max_tokens\": ${max_tokens},
      \"temperature\": 0.7,
      \"stream\": true
    }" 2>/dev/null | while IFS= read -r line; do
      if [[ "$line" == data:* ]] && [[ "$line" != "data: [DONE]" ]]; then
        local content=$(echo "$line" | sed 's/^data: //' | python3 -c "
import sys, json
try:
    d = json.load(sys.stdin)
    c = d.get('choices',[{}])[0].get('delta',{}).get('content','')
    if c: print(c, end='')
except: pass
" 2>/dev/null)
        if [ -n "$content" ] && [ -z "$first_token_time" ]; then
          first_token_time=$(python3 -c "import time; print(time.time())")
        fi
        token_count=$((token_count + 1))
      fi
    done

  local end_time=$(python3 -c "import time; print(time.time())")
  echo ""
  echo "STREAM_STATS|${start_time}|${first_token_time:-$end_time}|${end_time}|${token_count}"
}

extract_tokens() {
  local response="$1"
  echo "$response" | python3 -c "
import sys, json
lines = sys.stdin.read().strip().split('\n')
time_total = float(lines[-1])
body = '\n'.join(lines[:-1])
try:
    d = json.loads(body)
    usage = d.get('usage', {})
    prompt_tokens = usage.get('prompt_tokens', 0)
    completion_tokens = usage.get('completion_tokens', 0)
    total_tokens = usage.get('total_tokens', 0)
    content = d['choices'][0]['message']['content'][:100]
    print(f'{prompt_tokens}|{completion_tokens}|{total_tokens}|{time_total:.3f}|{content}')
except Exception as e:
    print(f'0|0|0|{time_total:.3f}|ERROR: {e}')
" 2>/dev/null
}

# ---- 测试 1: 健康检查 ----
echo -e "\n${YELLOW}[1/5] 健康检查...${NC}"
health=$(curl -s -o /dev/null -w "%{http_code}" "${API_URL}/health" 2>/dev/null || echo "000")
if [ "$health" = "200" ]; then
  echo -e "${GREEN}  ✅ API 服务正常${NC}"
else
  echo -e "  ❌ API 不可达 (HTTP $health),请检查服务是否启动"
  exit 1
fi

# ---- 测试 2: 短文本 TTFT + 生成速度 ----
echo -e "\n${YELLOW}[2/5] 短文本测试(prompt ~20 token,生成 128 token)...${NC}"
SHORT_PROMPT="用一段话介绍人工智能的发展历史"
short_result=$(call_api "$SHORT_PROMPT" 128 0.7)
short_parsed=$(extract_tokens "$short_result")

IFS='|' read -r s_pt s_ct s_tt s_time s_preview <<< "$short_parsed"
if [ "$s_ct" -gt 0 ] 2>/dev/null; then
  s_tps=$(python3 -c "print(f'{${s_ct}/${s_time}:.2f}')")
  echo -e "${GREEN}  ✅ 完成 | 耗时: ${s_time}s | 生成: ${s_ct} tokens | 速度: ${s_tps} tok/s${NC}"
  echo -e "  预览: ${s_preview}..."
else
  echo -e "  ❌ 失败: ${s_preview}"
  s_tps="N/A"
fi

# ---- 测试 3: 长文本生成 ----
echo -e "\n${YELLOW}[3/5] 长文本测试(生成 512 token)...${NC}"
LONG_PROMPT="请详细解释什么是 Transformer 架构,包括自注意力机制、多头注意力、位置编码、前馈网络等核心组件,并说明它在 NLP 中的重要性"
long_result=$(call_api "$LONG_PROMPT" 512 0.7)
long_parsed=$(extract_tokens "$long_result")

IFS='|' read -r l_pt l_ct l_tt l_time l_preview <<< "$long_parsed"
if [ "$l_ct" -gt 0 ] 2>/dev/null; then
  l_tps=$(python3 -c "print(f'{${l_ct}/${l_time}:.2f}')")
  echo -e "${GREEN}  ✅ 完成 | 耗时: ${l_time}s | 生成: ${l_ct} tokens | 速度: ${l_tps} tok/s${NC}"
else
  echo -e "  ❌ 失败: ${l_preview}"
  l_tps="N/A"
fi

# ---- 测试 4: 推理能力测试 ----
echo -e "\n${YELLOW}[4/5] 推理能力测试...${NC}"
REASON_PROMPT="一个农夫要把狐狸、鸡和一袋谷子运过河。船很小,只能装农夫和一样东西。如果农夫不在的时候,狐狸会吃鸡,鸡会吃谷子。请问农夫如何把三样东西都安全运到对岸?请一步步推理。"
reason_result=$(call_api "$REASON_PROMPT" 512 0.7)
reason_parsed=$(extract_tokens "$reason_result")

IFS='|' read -r r_pt r_ct r_tt r_time r_preview <<< "$reason_parsed"
if [ "$r_ct" -gt 0 ] 2>/dev/null; then
  r_tps=$(python3 -c "print(f'{${r_ct}/${r_time}:.2f}')")
  echo -e "${GREEN}  ✅ 完成 | 耗时: ${r_time}s | 生成: ${r_ct} tokens | 速度: ${r_tps} tok/s${NC}"
  echo -e "  预览: ${r_preview}..."
else
  echo -e "  ❌ 失败: ${r_preview}"
  r_tps="N/A"
fi

# ---- 测试 5: 简单并发测试(3 路) ----
echo -e "\n${YELLOW}[5/5] 并发测试(3 路同时请求)...${NC}"
CONC_PROMPT="请解释什么是量子计算"
conc_start=$(python3 -c "import time; print(time.time())")

call_api "$CONC_PROMPT" 128 0.7 > /tmp/bench_c1.txt &
PID1=$!
call_api "请解释什么是深度学习" 128 0.7 > /tmp/bench_c2.txt &
PID2=$!
call_api "请解释什么是区块链" 128 0.7 > /tmp/bench_c3.txt &
PID3=$!

wait $PID1 $PID2 $PID3 2>/dev/null
conc_end=$(python3 -c "import time; print(time.time())")
conc_total=$(python3 -c "print(f'{${conc_end} - ${conc_start}:.2f}')")

c1_parsed=$(extract_tokens "$(cat /tmp/bench_c1.txt)")
c2_parsed=$(extract_tokens "$(cat /tmp/bench_c2.txt)")
c3_parsed=$(extract_tokens "$(cat /tmp/bench_c3.txt)")

IFS='|' read -r _ c1_ct _ _ _ <<< "$c1_parsed"
IFS='|' read -r _ c2_ct _ _ _ <<< "$c2_parsed"
IFS='|' read -r _ c3_ct _ _ _ <<< "$c3_parsed"

total_conc_tokens=$((${c1_ct:-0} + ${c2_ct:-0} + ${c3_ct:-0}))
if [ "$total_conc_tokens" -gt 0 ] 2>/dev/null; then
  conc_tps=$(python3 -c "print(f'{${total_conc_tokens}/${conc_total}:.2f}')")
  echo -e "${GREEN}  ✅ 完成 | 总耗时: ${conc_total}s | 总 tokens: ${total_conc_tokens} | 聚合吞吐: ${conc_tps} tok/s${NC}"
else
  echo -e "  ⚠️ 部分请求可能失败"
  conc_tps="N/A"
fi

# ---- 生成报告 ----
echo -e "\n${CYAN}========================================${NC}"
echo -e "${CYAN} 测试完成,生成报告...${NC}"
echo -e "${CYAN}========================================${NC}"

cat > "$RESULT_FILE" << REPORT
# LLM 性能基准测试报告

- **测试时间**: $(date '+%Y-%m-%d %H:%M:%S')
- **模型**: ${MODEL}
- **标签**: ${LABEL}
- **API 端点**: ${API_URL}
- **测试机**: $(hostname)

## 测试结果

| 测试项 | Prompt Tokens | 生成 Tokens | 耗时(s) | 速度(tok/s) |
|--------|--------------|-------------|---------|-------------|
| 短文本(128) | ${s_pt} | ${s_ct} | ${s_time} | ${s_tps} |
| 长文本(512) | ${l_pt} | ${l_ct} | ${l_time} | ${l_tps} |
| 推理能力(512) | ${r_pt} | ${r_ct} | ${r_time} | ${r_tps} |
| 并发3路(128×3) | — | ${total_conc_tokens} | ${conc_total} | ${conc_tps} |

## 环境信息

\`\`\`
模型: ${MODEL}
标签: ${LABEL}
端点: ${API_URL}
时间: $(date '+%Y-%m-%d %H:%M:%S')
\`\`\`

## 推理能力测试回答预览

\`\`\`
${r_preview}...
\`\`\`
REPORT

echo -e "${GREEN}报告已保存: ${RESULT_FILE}${NC}"
echo ""
cat "$RESULT_FILE"
# 在 spark03 上启动服务端
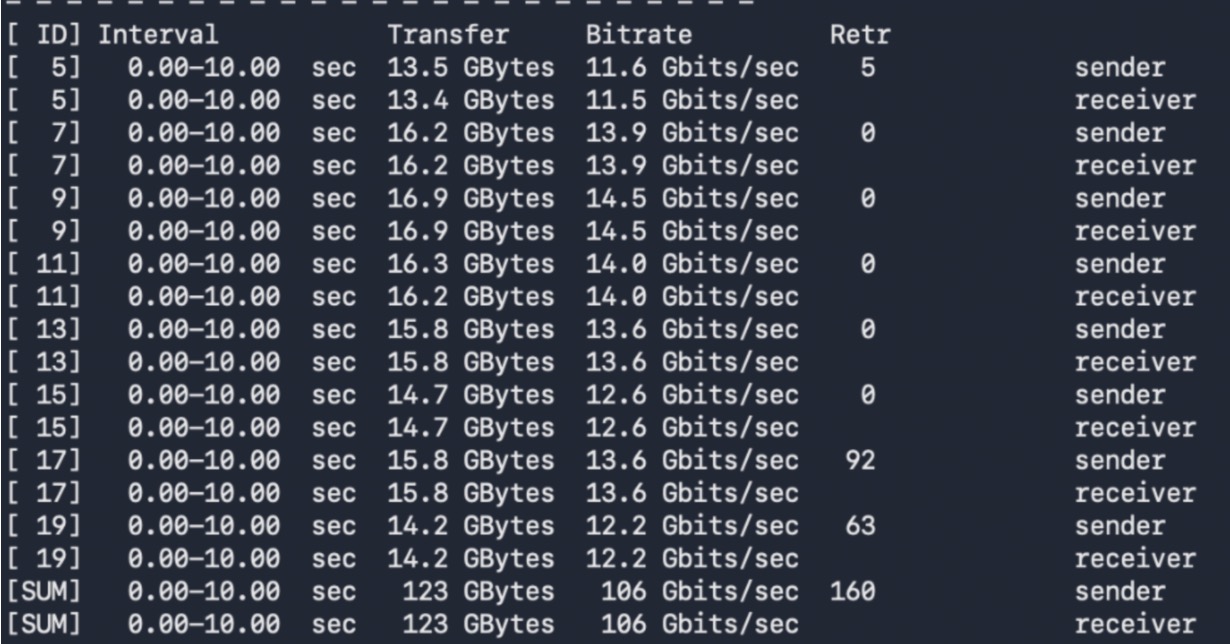
ssh spark3 'iperf3 -s'

# 在 spark02 上测试(走高速互联)
ssh spark2 'iperf3 -c 192.168.100.2 -t 10 -P 8'
注意事项
通过 QSFP56(200GbE)跨机传输文件时,因 TCP 缓冲区不足引发大量 TCP 重传(33913次),需优化以下内核参数
# 两台机器都要执行
cat >> /etc/sysctl.d/99-tcp-tuning.conf << 'EOF'
# 200G 网络 TCP 大缓冲区优化
net.core.rmem_max = 536870912
net.core.wmem_max = 536870912
net.ipv4.tcp_rmem = 4096 87380 536870912
net.ipv4.tcp_wmem = 4096 65536 536870912
net.ipv4.tcp_congestion_control = bbr
EOF

# 立即生效(无需重启)
sysctl -p /etc/sysctl.d/99-tcp-tuning.conf

echo "配置已持久化,重启后自动生效"
感谢,我今晚刚弄得这个双机互联iperf3 跑107g 我还一直在找原因 原来真是pcie 4x的问题
能帮到你,深感欣慰