NVIDIA DGX Spark走在时代的前列线上
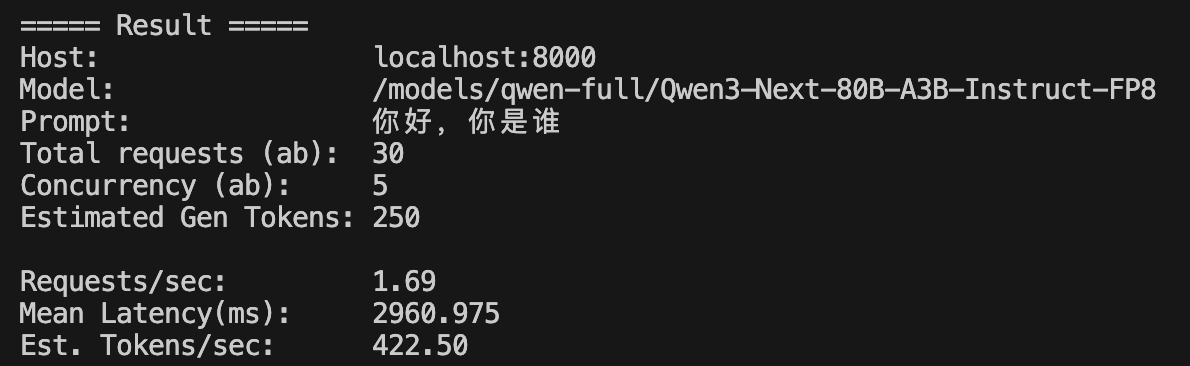
3万人民币出头,可以买到支持cuda、原厂出品且合法的桌面AI工作站。测试Qwen3-Next-80B-A3B-Instruct-FP8 占满显存,基本是可以运行的最大尺寸模型,每秒生成422个tokens!
# ab_benchmark.sh
#!/usr/bin/env bash
set -euo pipefail

usage() {
  cat <<EOF
Usage: $0 -h <host:port> -m <model> -p <prompt> -g <gen_tokens> -n <total_requests> -c <concurrency>

Required:
  -h  Host:Port of vLLM server (e.g., 127.0.0.1:8000)
  -m  Model identifier (as you use in request)
  -p  Prompt text (e.g., "你好,你是谁?")
  -g  Expected generated token count (integer)
  -n  Total number of requests for ab
  -c  Concurrency for ab

Example:
  $0 -h 127.0.0.1:8000 -m "/models/qwen-full/Qwen3-Next-80B-A3B-Instruct-FP8" \
    -p "你好,你是谁" -g 128 -n 100 -c 5
EOF
  exit 1
}

HOST=""
MODEL=""
PROMPT=""
GEN_TOKENS=""
TOTAL_REQ=""
CONCURRENCY=""

while getopts "h:m:p:g:n:c:" opt; do
  case $opt in
    h) HOST="$OPTARG";;
    m) MODEL="$OPTARG";;
    p) PROMPT="$OPTARG";;
    g) GEN_TOKENS="$OPTARG";;
    n) TOTAL_REQ="$OPTARG";;
    c) CONCURRENCY="$OPTARG";;
    *) usage;;
  esac
done

if [[ -z "$HOST" || -z "$MODEL" || -z "$PROMPT" || -z "$GEN_TOKENS" || -z "$TOTAL_REQ" || -z "$CONCURRENCY" ]]; then
  usage
fi

AB_LOG="ab_chat_${MODEL//[:\/]/_}_${TOTAL_REQ}n_${CONCURRENCY}c.log"
PAYLOAD="ab_chat_payload.json"

# Build the payload
cat > $PAYLOAD <<EOF
{
  "model": "${MODEL}",
  "messages": [
    {"role": "system", "content": "你是一个有帮助的AI助手"},
    {"role": "user", "content": "${PROMPT}"}
  ],
  "temperature": 0,
  "max_tokens": ${GEN_TOKENS}
}
EOF

echo "Running ab with payload:"
cat $PAYLOAD
echo

# Run ApacheBench
ab -n $TOTAL_REQ -c $CONCURRENCY -s 30000 \
  -T "application/json" \
  -p $PAYLOAD \
  http://${HOST}/v1/chat/completions > $AB_LOG 2>&1

echo "ab log saved to $AB_LOG"
echo

# Extract metrics
RPS=$(grep "Requests per second:" $AB_LOG | head -n1 | awk '{print $4}')
MEAN_LAT=$(grep "Time per request:" $AB_LOG | head -n1 | awk '{print $4}')
# Estimate token throughput
TPS_EST=$(echo "$RPS * $GEN_TOKENS" | bc)

echo "===== Result ====="
echo "Host:                 $HOST"
echo "Model:                $MODEL"
echo "Prompt:               $PROMPT"
echo "Total requests (ab):  $TOTAL_REQ"
echo "Concurrency (ab):     $CONCURRENCY"
echo "Estimated Gen Tokens: $GEN_TOKENS"
echo
echo "Requests/sec:         $RPS"
echo "Mean Latency(ms):     $MEAN_LAT"
echo "Est. Tokens/sec:      $TPS_EST"
echo
# 启动方法
./ab_benchmark.sh \
-h localhost:8000 \
-m "/models/qwen-full/Qwen3-Next-80B-A3B-Instruct-FP8" \
-p "你好,你是谁" \
-g 250 \
-n 30 \
-c 5