什么?阿里云DNS提供cname权重啦?
突然在阿里云控制台上看到,可以设置cname的权重,印象里只有mx记录有优先级!特意去查了DNS规范,确实没有
实践是检验真理的唯一标准,开干

按标准dns协议,cname记录是没有“权重”、“优先级”的,阿里应该是自己实现,不是标准,无法影响其他DNS服务器,换句话说,通过DNS控制服务权重不可靠,用户必须使用阿里的dns才能实现。当玩具用吧
突然在阿里云控制台上看到,可以设置cname的权重,印象里只有mx记录有优先级!特意去查了DNS规范,确实没有
实践是检验真理的唯一标准,开干
按标准dns协议,cname记录是没有“权重”、“优先级”的,阿里应该是自己实现,不是标准,无法影响其他DNS服务器,换句话说,通过DNS控制服务权重不可靠,用户必须使用阿里的dns才能实现。当玩具用吧
背景:
位于阿里云的kubernetes集群,通过ingress svc暴露,类型为ClusterIP。某天在对集群内大量缩容节点时,马上出现了大量的502、504报警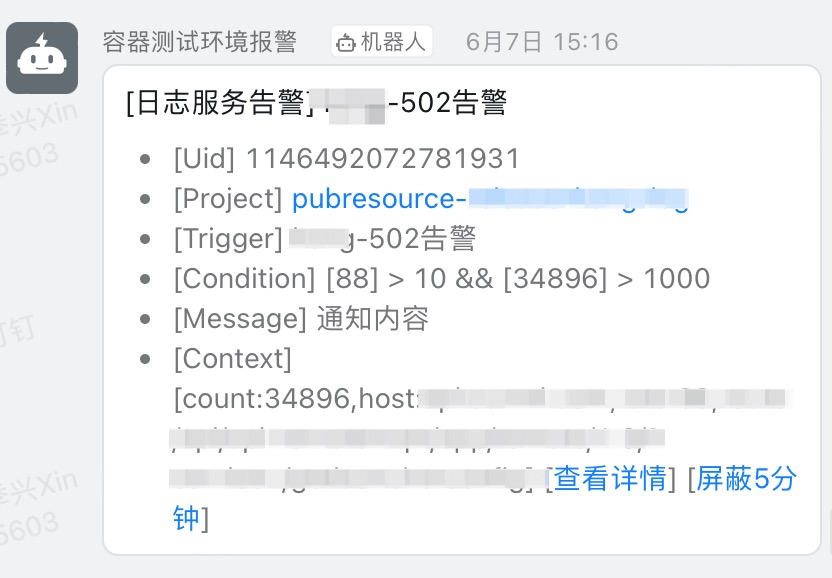
以为外部密集请求导致后端服务受影响,从监控观察并无异常,联想到最近的变更,怕不是缩容导致?正在排查的过程中,服务恢复。事后通过工单确认 ClusterIP类型的SLB后端的rs被移除时,SLB的操作就是静默丢包,也就是该SLB对任何发过来的tcp包都会默认丢弃,DROP并不会响应
文档描述
https://help.aliyun.com/zh/ack/ack-managed-and-ack-dedicated/user-guide/add-annotations-to-the-yaml-file-of-a-service-to-configure-clb-instances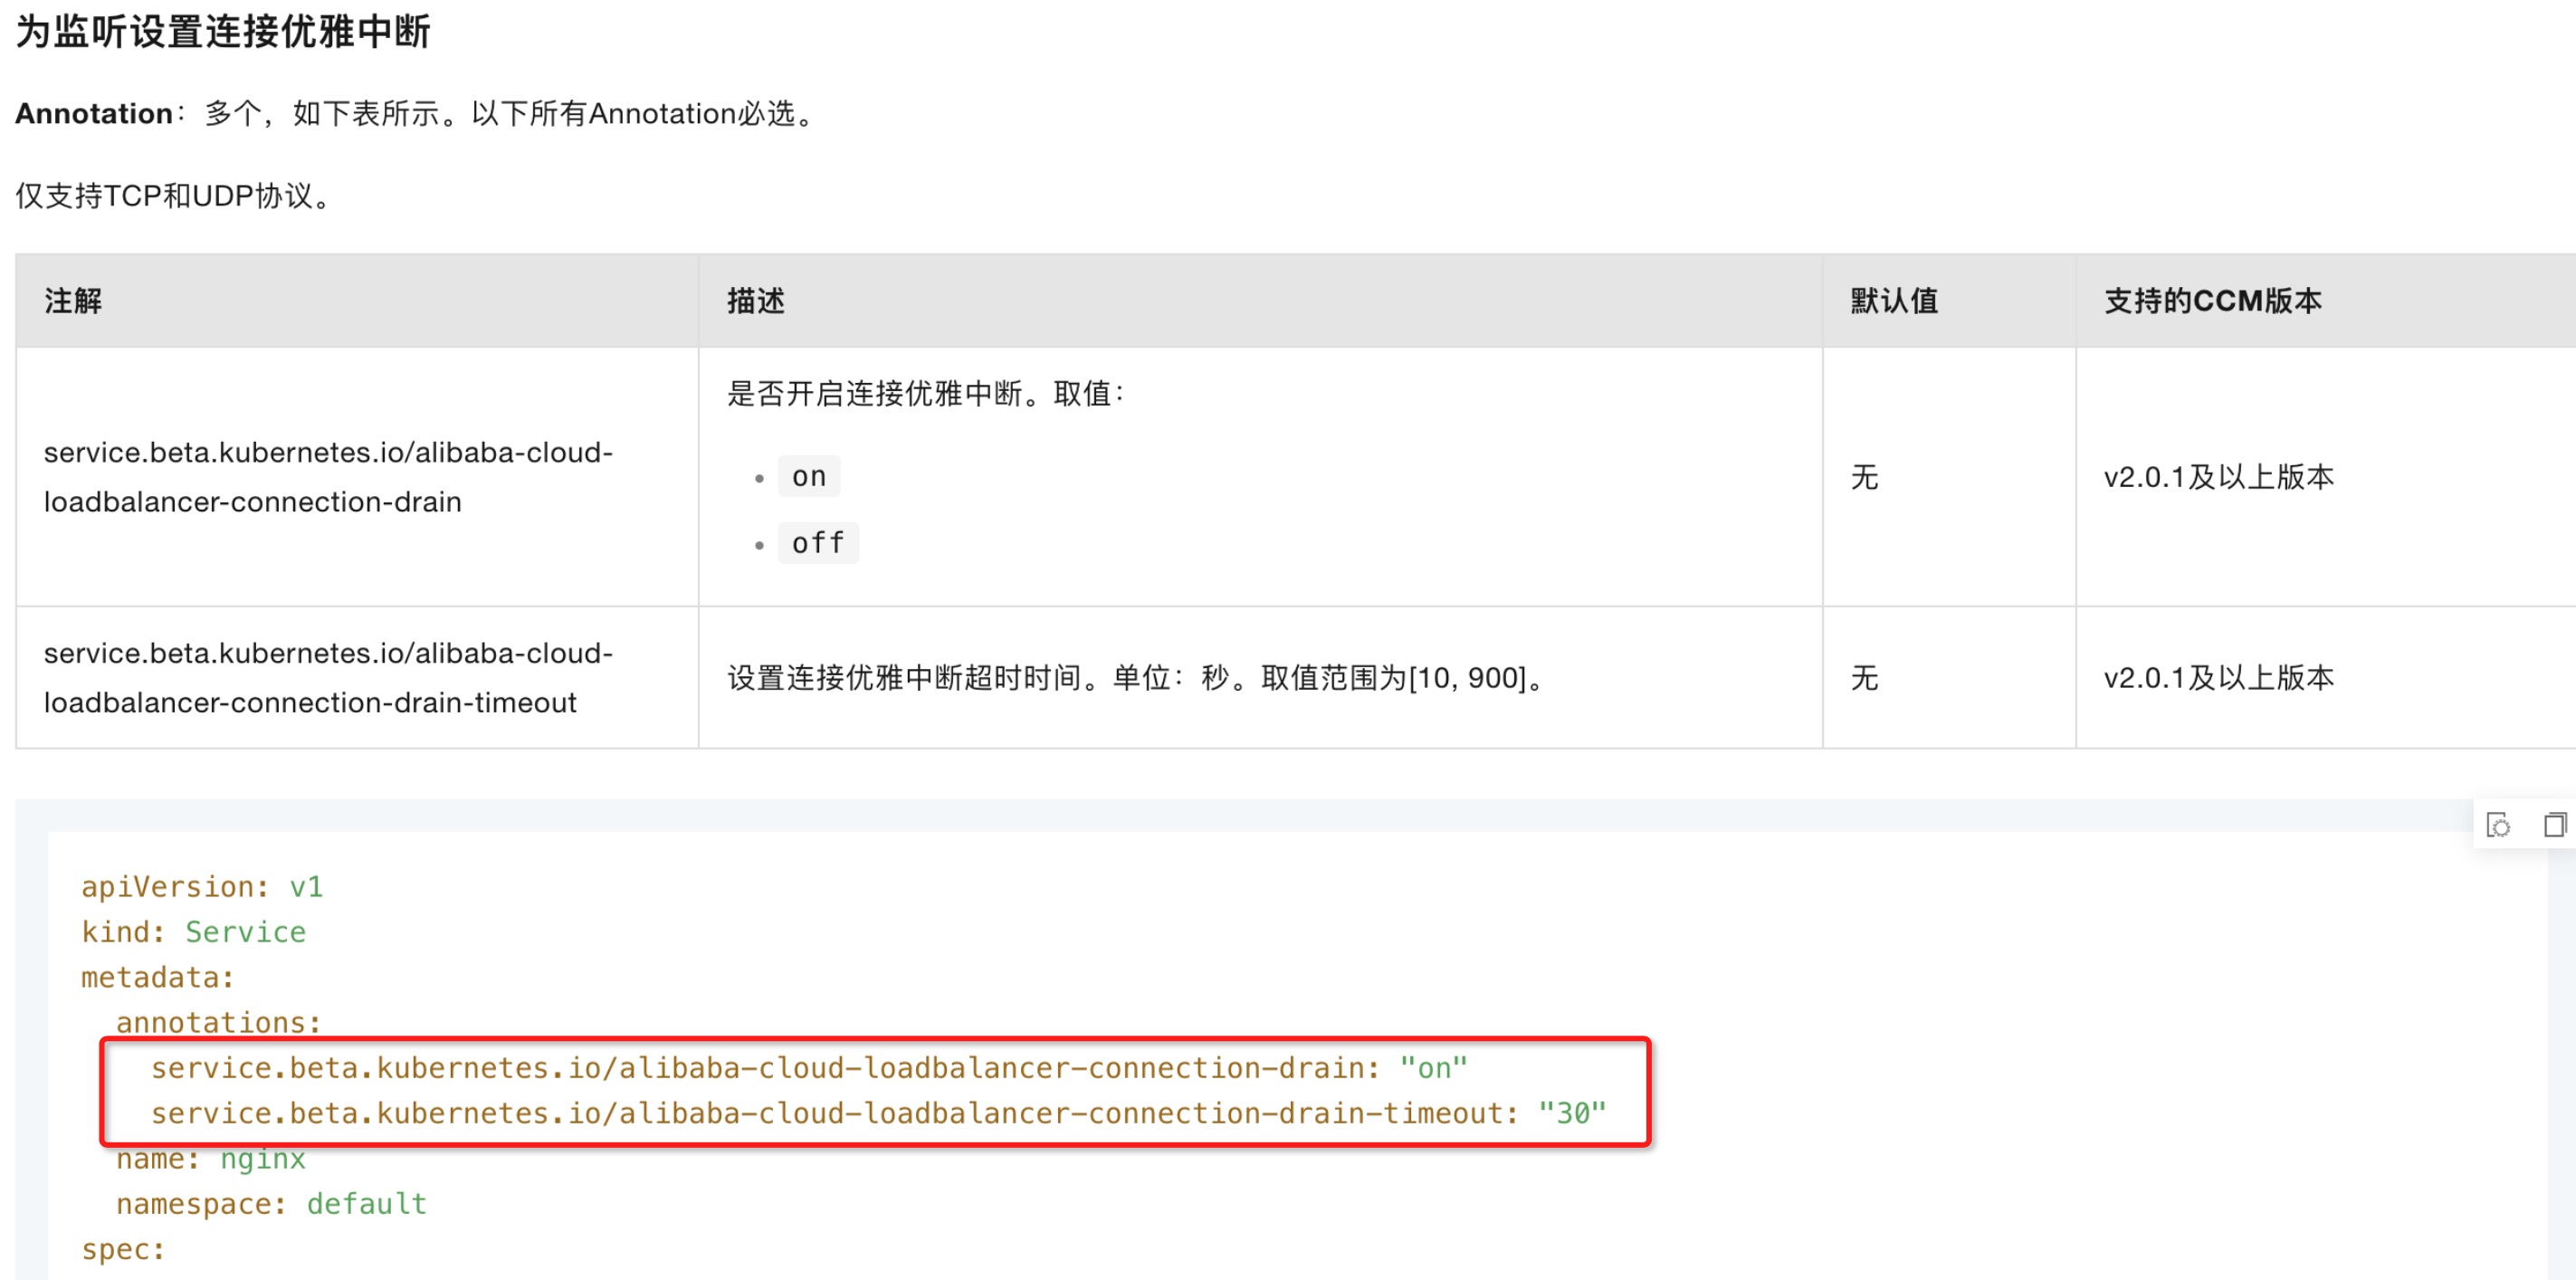
最终解法
某日读写分离中间件报警,有大量非业务IP连接涌入,新连接无法建立。查询数据库连接有大量的”unauthenticated user 1.2.3.4:37414 NULL Connect NULL Reading from net NULL”。一时间大量用户报障,“登录失效”、“设备断连”、“影响产线生产”等等
解决过程倒不复杂,跳过中间件恢复。售后工程师承认是中间件设计问题,释放连接逻辑bug,也提到了有大量连接时可能触发!
反观自身,架构设计阶段把过多的压力放在主库,19年上线的读写分离中间件就是“业务迭代优先,没时间基础设施改造”、“历史包袱”背景下的缓兵之计。阿里云的问题有几点
1.中间件控制台无法显示真实IP,故障后对方研发回复“日志因升级规格消失?”
2.假死后控制台无法重启
3.控制台监控不准确,使用者无法准确选择
4.1.2版本释放连接逻辑bug
主因是内部某服务突然建立了大量连接,进而引发的故障。
开发阶段把更多的重点放在功能实现和业务迭代上,而忽略了基础设施的可扩展性。这可能会造成短期内的业务顺利进行,但长期看来,如果基础设施不能跟上业务的发展,最终可能会形成技术债务,导致在运维阶段遇到无法解决或者处理复杂度高的问题。
云服务提供商的SLA(服务等级协议)是我们选择使用其服务的一个重要依据,但是是否100%信任SLA,我们需要结合自身的业务情况和对服务提供商的了解来决定。在应急情况下,我们可能需要更具备自主的故障应对能力,而不是完全依赖服务提供商的SLA。