260911大模型 AIOps 诊断能力排行榜
合适的才是最好的,基于AIOpslab项目,考察模型在解决物理世界问题的能力,直接看效果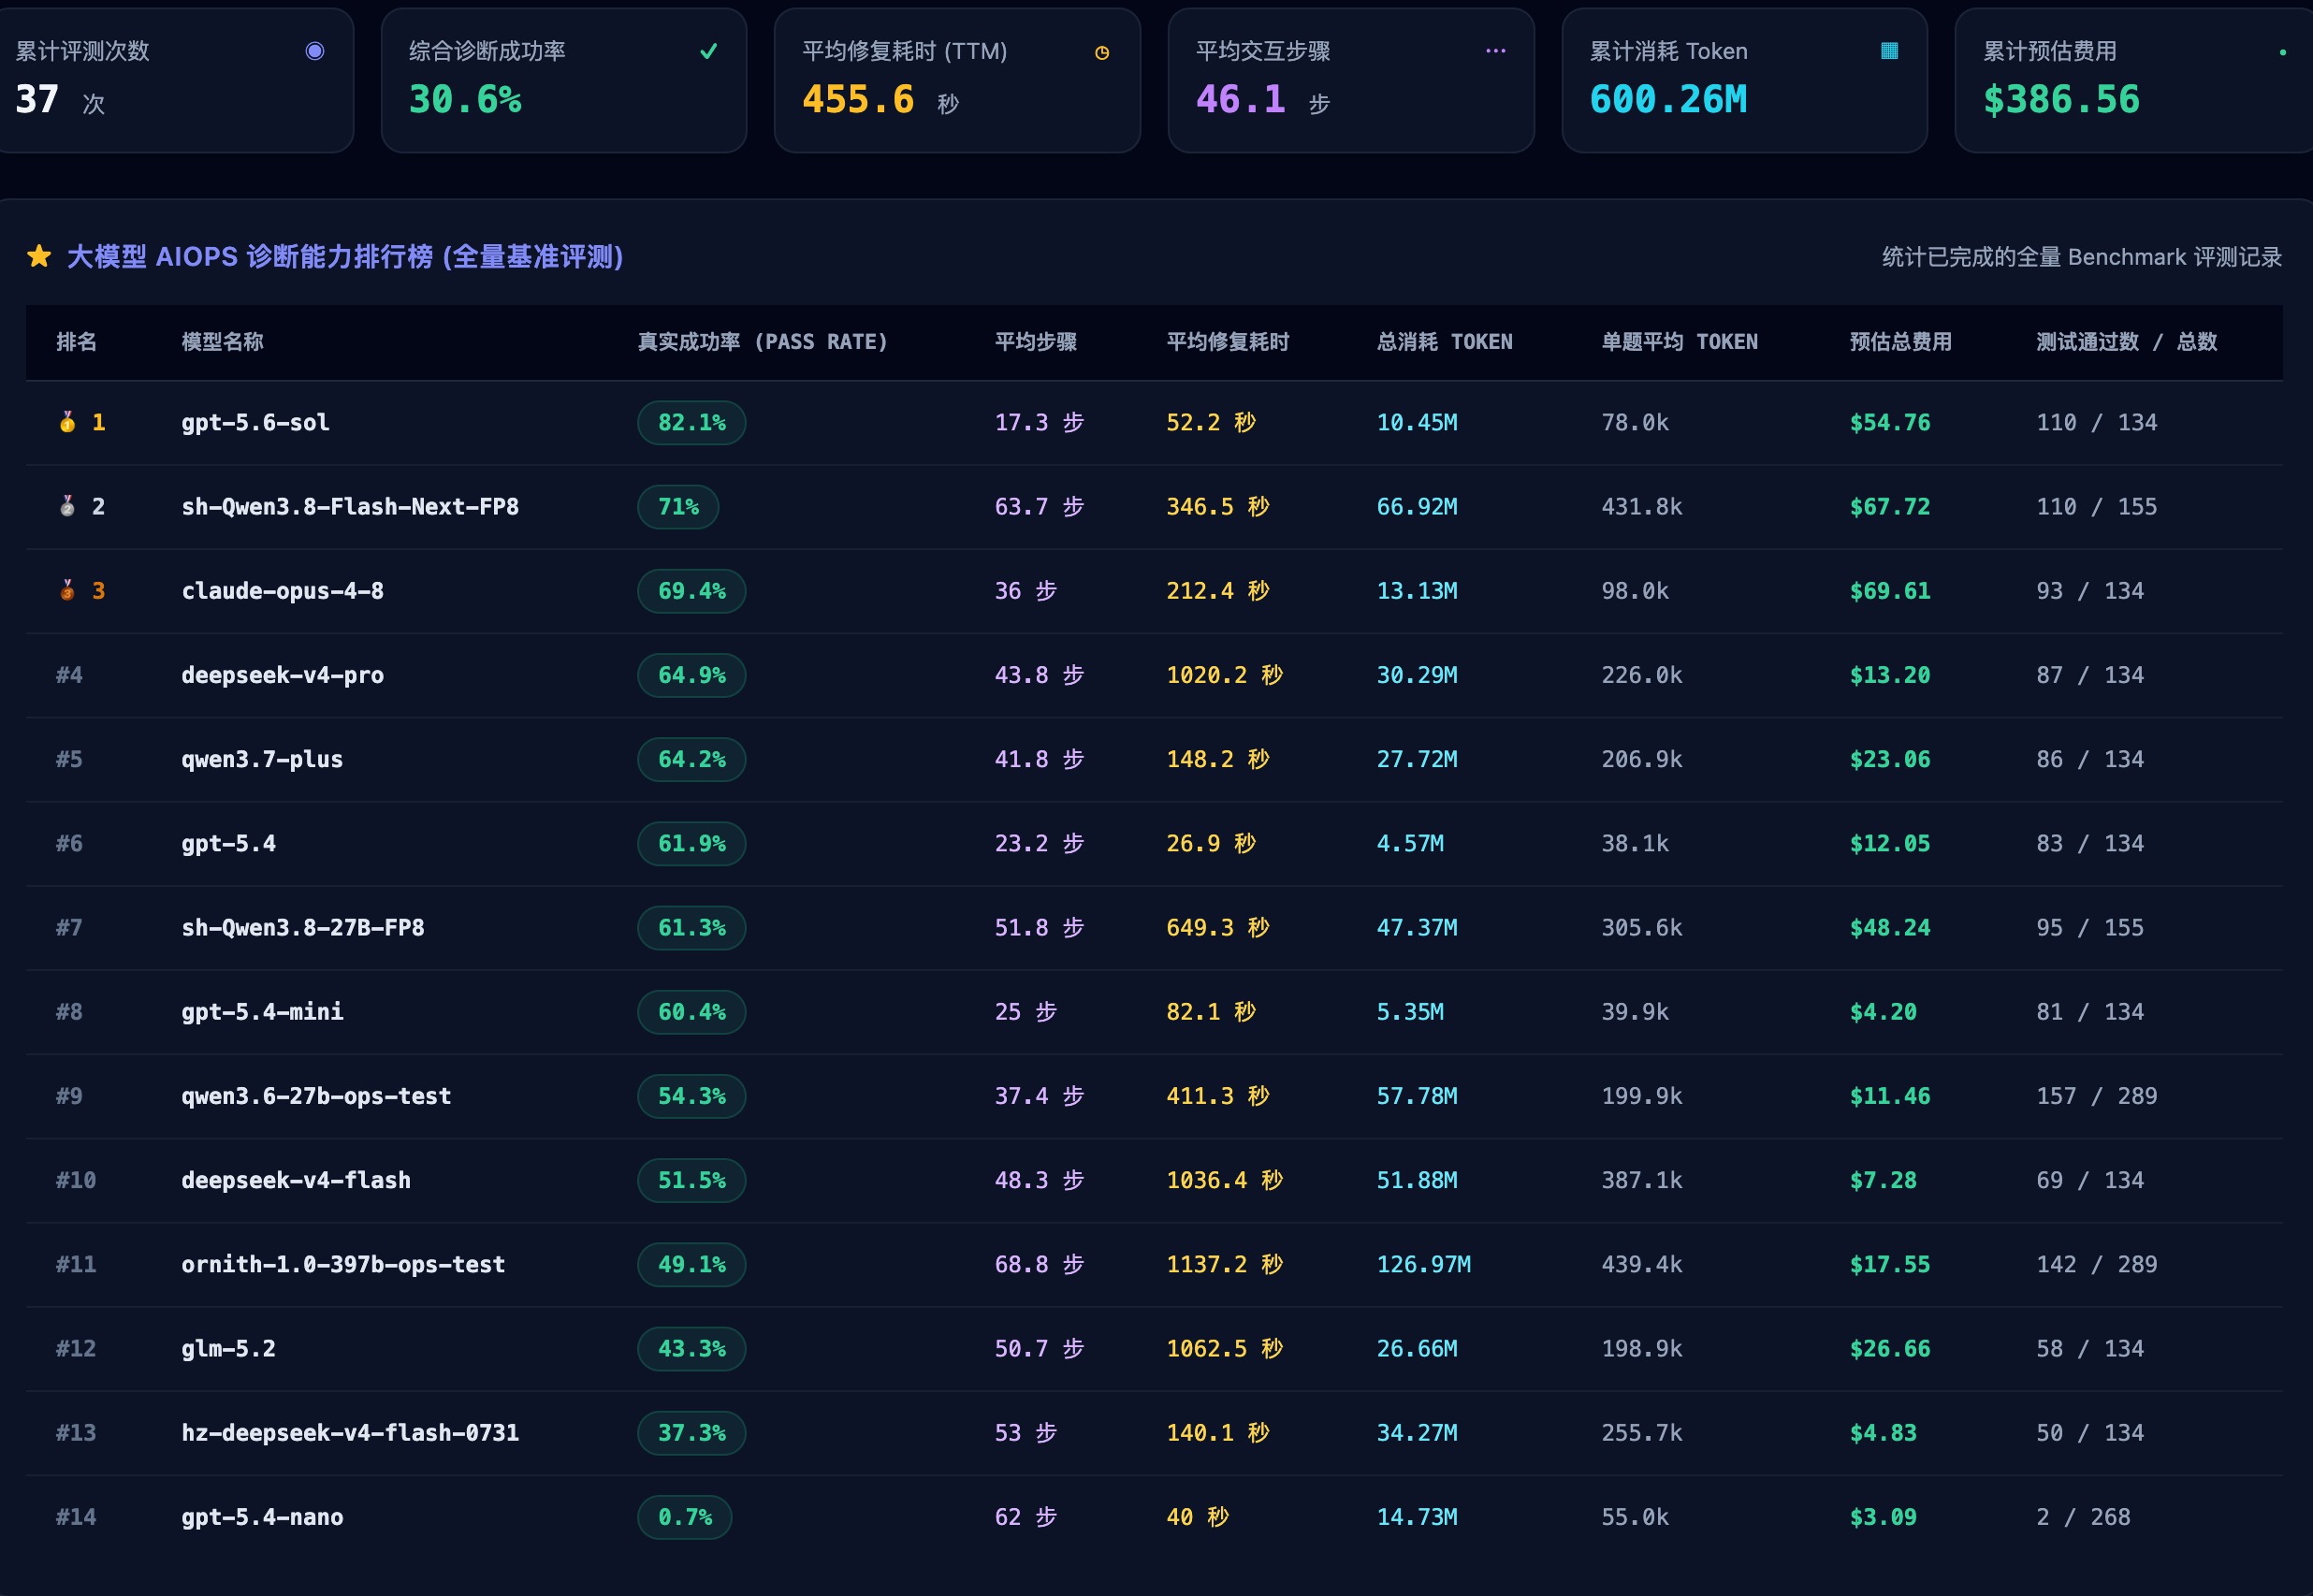
合适的才是最好的,基于AIOpslab项目,考察模型在解决物理世界问题的能力,直接看效果
网关有了(见前篇 LiteLLM),模型接了一堆,下一个问题很自然:这些模型到底会不会干运维的活?
拿面试题问"CrashLoopBackOff 怎么排查"是测不出来的,背题谁不会。得来真的:给它一个真集群、一个真故障、一套真的 kubectl,看它能不能自己查出来、修回去。
用微软开源的 AIOpsLab 攒了一个:7 台测试机搭 K8s,上面跑三套真实微服务(酒店预订、社交网络、电商商城),基于混沌工程往里注故障——Chaos Mesh 杀 Pod、注网络延迟丢包,feature flag 触发应用级异常,再配合压测流量把症状放大。
一共 87 道题,全是线上见过的那类复杂问题:
每道题模型要闯四关:检测(有没有问题)→ 定位(哪个服务)→ 分析(根因是什么)→ 修复(自己动手修好)。全程模型自主操作,跑完自动评分。
(部署过程小折腾:镜像走本机中转、init 容器里的 git clone 内网化、remote chart 本地化——一句话总结,评测环境的一切外网依赖都要掐死,按下不表。)
三个模型同题同环境:gpt-5.4、glm-5.2、deepseek-v4-flash。
| gpt-5.4 | glm-5.2 | deepseek-v4-flash | |
|---|---|---|---|
| 总体正确率 | 60% | 59% | 60% |
| 平均解题耗时 | 19秒 | 106秒 | 155秒 |
| 平均交互步数 | 11步 | 21步 | 22步 |
| token(入/出) | 1022k/27k | 1627k/64k | 1898k/57k |
| 分任务 | gpt-5.4 | glm-5.2 | deepseek-v4-flash |
|---|---|---|---|
| 检测 | 62% | 59% | 68% |
| 定位 | 56% | 63% | 54% |
| 分析 | 31% | 23% | 23% |
| 修复 | 93% | 86% | 93% |
两个结论:
gpt-5.4 依然"又快又准"——五分之一的耗时、一半的步数和 token,拿到同样的分。这个效率差接到告警自动处置上就是 MTTR 的量级差异。
但更让人欣喜的是国产开源模型的成色:glm-5.2 和 deepseek-v4-flash 正确率跟 GPT 打平了,无非是耗时增加——靠多翻几轮日志、多查几次指标把分堆出来。勤能补拙,慢一点,但结果不输。放在两年前,这个差距还是"能不能做到"级别的,现在只剩"多花几十秒"。
顺带两个观察:三家都是修复强(86~93%)、分析弱(23~31%),模型会修不会说;kubectl 能看到的基础设施故障都能拿 70%+,要读 trace 的应用级故障集体跳水到 20% 上下——这决定了它们现在能接什么活。
运维数据是最敏感的那类数据:拓扑、配置、日志、告警,全是家底。ops-agent 走公网 API,能力再强也是把家底往外递。
现在量化结果摆在这:开源模型的运维能力已经追平闭源 API,代价只是耗时。而对告警处置这个场景,慢一两分钟远比数据出域可接受。
所以下一步已经定了:把 ops-agent 切到本地模型(L20 上的 deepseek 正好派上用场,见前篇),数据不出内网——安全闭环的最后一块拼图。正在验证中,效果如何,下篇见。